OpenAI annonce un assistant de recherche automatisé : ce que cela signifie vraiment
OpenAI mesure désormais 3,1 journées-agent par journée humaine dans sa recherche. Décryptage des résultats, des limites et d’une méthode pour évaluer un agent sans confondre activité et progrès.
Rédaction Cresora IAVeille mondiale · Méthode éditoriale vérifiableObjectif : comprendre le jalon annoncé par OpenAI et disposer d’un protocole concret pour superviser un agent de recherche ou de code sur une tâche bien délimitée.Dossier : Comparer les modèles IA du monde entier →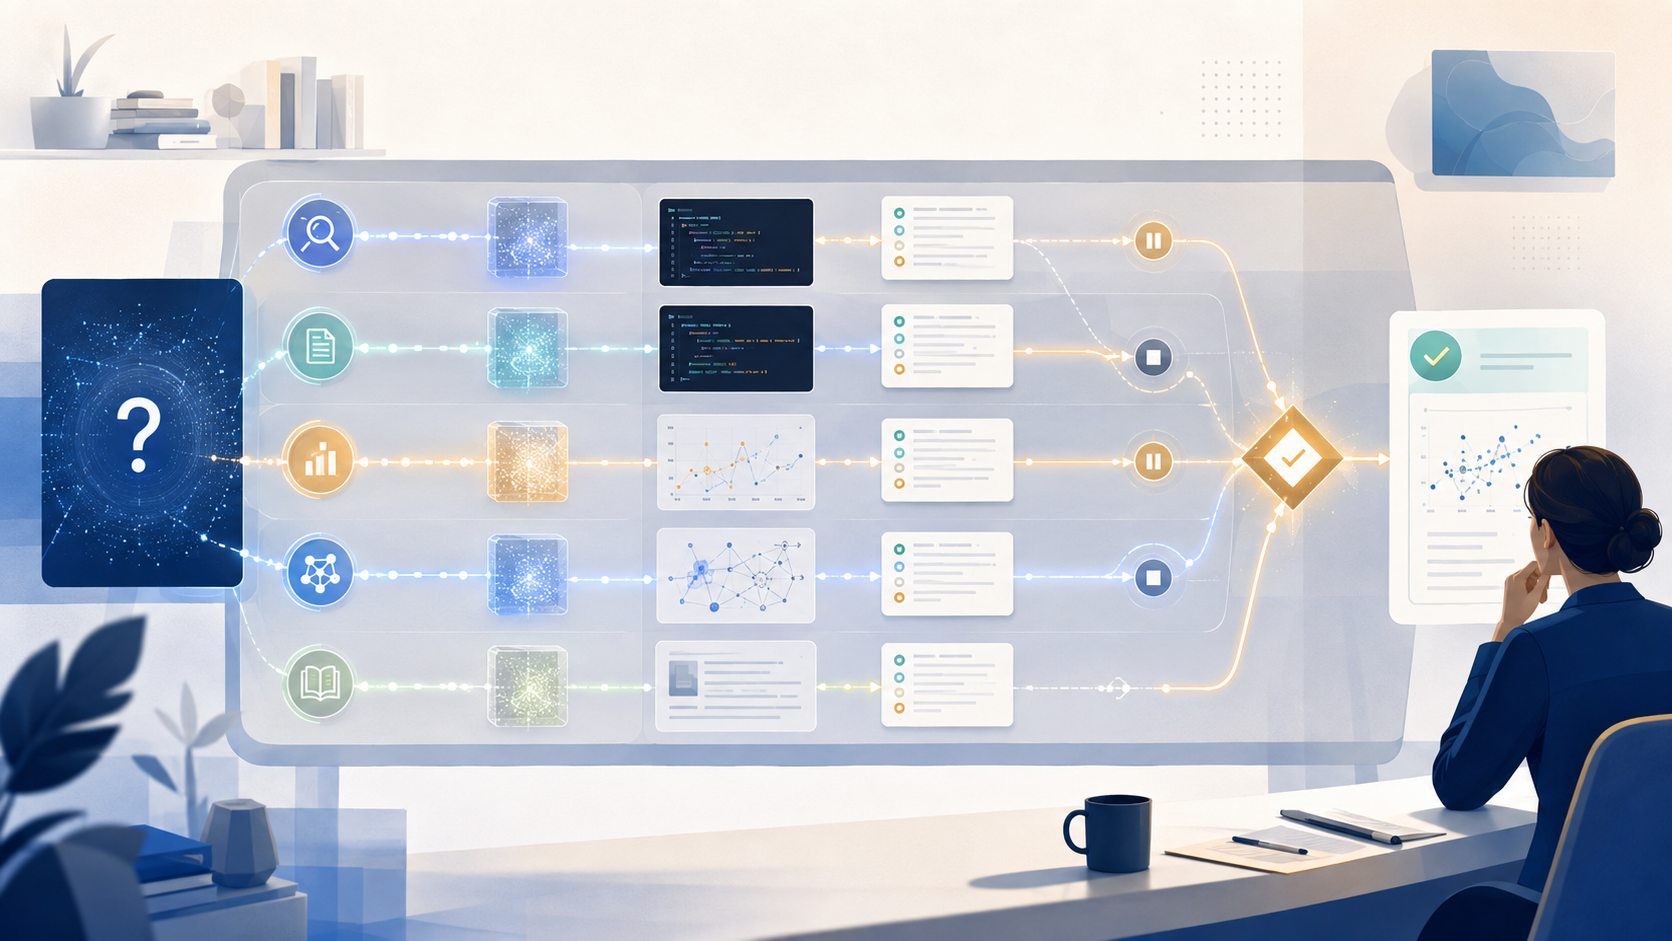
Le jalon annoncé le 6 septembre
OpenAI affirme avoir atteint son objectif fixé pour septembre 2026 : disposer d’un « assistant de recherche automatisé ». L’expression désigne, dans sa propre définition, un système capable d’accomplir sous direction humaine des tâches de recherche bien définies qui prendraient quelques jours à une personne qualifiée. Ce n’est ni un laboratoire autonome, ni un chercheur qui choisit seul les problèmes, ni un produit commercial annoncé pour le public.
L’entreprise fixe maintenant un objectif plus ambitieux pour mars 2028 : un chercheur IA automatisé. Cette trajectoire reste une ambition, pas une disponibilité promise. OpenAI précise que les humains choisissent encore les priorités, évaluent les idées, décident de changer d’échelle, interrompent les travaux et autorisent les déploiements. Le mot important dans le jalon de 2026 est donc « assistant » ; le second est « sous direction humaine ».
Fait vérifié : OpenAI revendique un jalon interne. Analyse Cresora : cela documente une évolution rapide du travail de recherche, mais ne prouve pas une autonomie scientifique générale.
Que mesure réellement le chiffre de 3,1 journées-agent
À la mi-août, l’organisation de recherche d’OpenAI utilisait, au total, 3,1 journées-agent normalisées de huit heures pour chaque journée de travail humain. Le chercheur médian consommait plus de 600 dollars par jour aux prix API et le 90e percentile dépassait 7 000 dollars. Ces montants décrivent un équivalent de consommation interne ; ils ne constituent pas le tarif d’une nouvelle offre accessible en France.
Une journée-agent n’équivaut pas à une journée de progrès. Plusieurs agents peuvent explorer en parallèle des pistes inutiles, répéter une erreur ou produire du code qui doit être corrigé. La mesure indique l’ampleur de l’activité automatisée et de la concurrence des sessions, pas le nombre de découvertes validées. Pour parler de productivité, il faudrait relier ce temps à des résultats comparables, reproductibles et utiles, puis retrancher le coût de préparation, de surveillance et de reprise.
Plus de code et d’expériences ne signifie pas automatiquement plus de science
OpenAI observe davantage de code produit et un record d’expériences par chercheur actif en août. L’adoption de Codex est corrélée à cette hausse. Mais l’entreprise reconnaît aussi que le calcul disponible a fortement augmenté depuis 2025. Une corrélation entre usage d’agents, volume de code et nombre d’expériences ne permet donc pas d’attribuer toute l’accélération au modèle.
La recherche avance quand l’ensemble de la boucle fonctionne : choisir une question, concevoir l’expérience, écrire l’évaluation, exécuter correctement, repérer les comportements indésirables, interpréter les résultats et intégrer seulement les idées solides. Automatiser une étape peut déplacer le goulot d’étranglement vers la validation, le calcul ou le jugement. Une équipe qui génère dix fois plus d’essais médiocres peut ralentir si personne ne dispose du temps nécessaire pour les comprendre.
Les tâches longues réussissent encore avec des interventions
OpenAI indique que les taux de réussite ont progressé entre janvier et juillet sur plusieurs niveaux de difficulté, pour les sessions dont l’issue pouvait être rattachée à une vérité de référence. Pourtant, plus de la moitié des tâches réussies estimées à quatre à huit heures ont nécessité au moins une intervention humaine durant les six derniers mois. La réussite observée ne décrit donc pas une exécution silencieuse de bout en bout.
Cette intervention peut être une clarification, une correction de cap, l’apport d’un accès, l’arrêt d’une mauvaise piste ou la validation d’un résultat. Elle n’est pas un défaut en soi : une supervision au bon moment économise des heures. Mais elle doit être comptée. Présenter uniquement la durée autonome la plus longue masquerait le travail de cadrage et de contrôle qui rend cette durée possible.
Décider, concevoir, construire, exécuter, analyser et communiquer
Pour lire ses usages, OpenAI reprend une taxonomie proposée par Epoch AI. Elle répartit la R&D en six familles : décider, concevoir, construire, exécuter, analyser et communiquer. Selon le billet, toutes progressent, mais la planification de haut niveau reste une part minime des jetons produits. L’assistance technique, le dépannage et la surveillance des expériences prennent davantage de place.
Cette décomposition évite de déclarer « la recherche est automatisée » parce que l’écriture de code l’est partiellement. Pour une TPE, le même principe s’applique : décomposer « préparer une étude de marché » en choix de question, liste des sources, collecte, vérification, analyse, décision et communication. L’agent peut mener plusieurs sous-tâches ; la responsabilité finale et les critères d’arrêt restent explicitement attribués.
- Décider : formuler la question et le seuil d’utilité
- Concevoir : écrire hypothèses, méthode et critères
- Construire : préparer code, données ou documents
- Exécuter : lancer dans un environnement limité
- Analyser : comparer au résultat attendu et chercher les erreurs
- Communiquer : distinguer faits, incertitudes et décision humaine
Le coût doit être rapporté au résultat validé
Les montants internes publiés montrent qu’un usage intensif peut mobiliser beaucoup de calcul. Ils ne sont pas transposables directement à une petite équipe : OpenAI travaille sur ses propres modèles, infrastructures et expériences. Ils rappellent néanmoins qu’un agent parallèle n’est pas gratuit. Le coût complet comprend l’inférence, les environnements d’exécution, les données, la surveillance, les relances, les erreurs et le temps humain de revue.
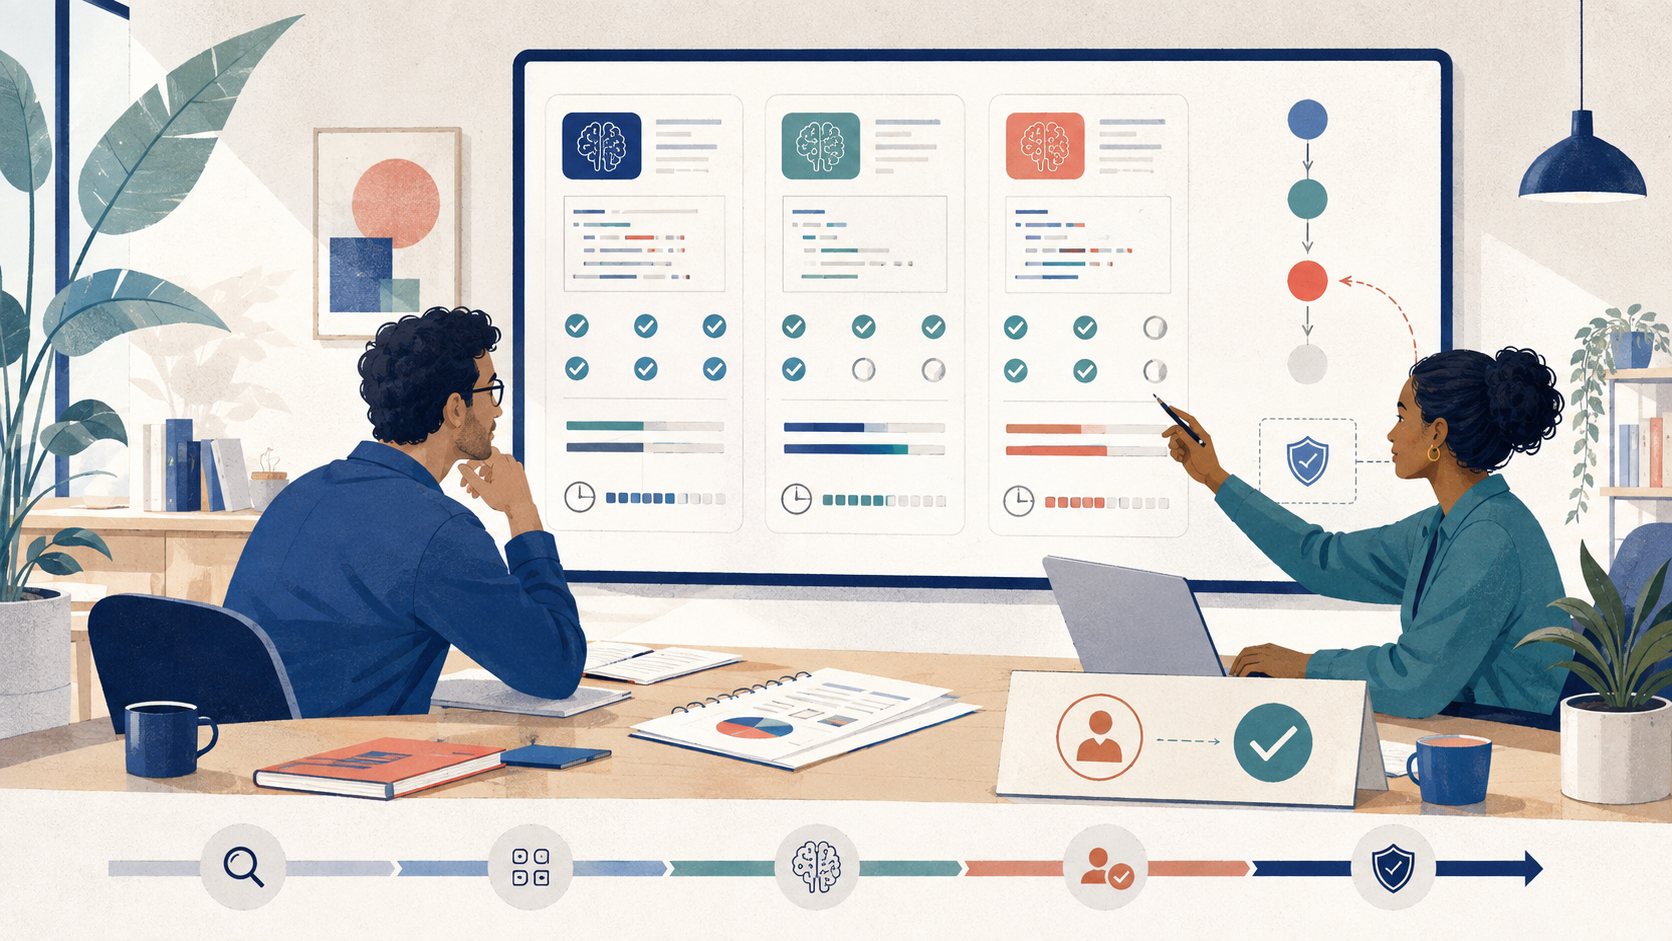
Mesurez plutôt le coût par résultat accepté. Notez le nombre de tâches lancées, celles terminées, celles réellement validées, les minutes de contrôle, les incidents et les résultats réutilisables. Une expérience qui échoue proprement et explique pourquoi peut avoir de la valeur ; une longue exécution qui produit un rapport impossible à reproduire n’en a presque aucune. Le volume de jetons ou d’heures-agent ne doit jamais devenir une cible de performance.
La sécurité peut freiner une classe de modèles sans réduire tout le calcul
Le billet relie les métriques de productivité à des incidents et restrictions. Après la compromission d’une infrastructure de recherche, OpenAI a interrompu puis rétabli avec davantage de contraintes un service de conteneurs. Après des indices de capacités cyber critiques pour Astra, l’allocation de calcul d’entraînement par renforcement de cette classe a chuté de 59,2 %. En parallèle, l’allocation d’autres modèles a augmenté de 17,2 %, compensant environ 85 % de la baisse.
Ce déplacement est un enseignement de gouvernance : limiter une ressource précise ne garantit pas un ralentissement global si le calcul peut être réaffecté. OpenAI décrit désormais l’isolation des charges, des contrôles réseau, des tests continus et une surveillance renforcée comme des garde-fous nécessaires. Pour une petite organisation, la traduction est plus simple : un agent ne reçoit que les outils, fichiers et réseaux nécessaires, et toute action irréversible exige une approbation.
Une pause sur un modèle ne suffit pas si les objectifs, le calcul et les autres modèles peuvent poursuivre presque la même boucle. Le contrôle doit porter sur le système complet.
Cas pratique : tester un agent sur une veille réglementaire fictive
Une petite entreprise veut savoir si un agent peut préparer une veille sans exposer ses dossiers. Elle choisit un corpus public de vingt pages déjà datées, cinq questions dont les réponses sont connues et deux questions impossibles. L’agent travaille dans un dossier isolé, sans messagerie, sans base client et sans droit de publier. Il doit fournir pour chaque conclusion le passage source, la date et un niveau d’incertitude.
Le test est réussi seulement si les cinq réponses vérifiables sont exactes, si les deux absences sont reconnues, si aucun lien n’est inventé et si la synthèse peut être reproduite. L’équipe mesure aussi le temps de préparation, les interventions, le coût et la correction. Elle ne connecte une nouvelle source qu’après trois essais sans erreur critique. La production reste manuelle tant que le processus de validation n’a pas prouvé sa stabilité.
Le protocole de supervision en huit étapes
Commencez par une tâche fermée dont la réussite peut être observée. Écrivez les entrées autorisées, les sorties attendues, la durée maximale, le budget et les actions interdites. Préparez ensuite une référence : résultat humain antérieur, tests automatiques, passages sources ou grille de notation. Sans cette référence, l’agent peut sembler actif sans que personne sache s’il progresse.
Ajoutez des points de contrôle plutôt que de surveiller chaque détail. Une validation avant l’accès aux données, une autre avant l’exécution coûteuse et une dernière avant diffusion suffisent souvent. Journalisez commandes, sources, versions et interventions. À la fin, rejouez l’expérience depuis un environnement propre. Si le résultat dépend d’un historique caché ou d’une correction non documentée, il n’est pas prêt à devenir une procédure.
- Définir une question et un livrable observables
- Fixer sources, outils, budget et durée
- Interdire publication, paiement et action irréversible
- Préparer une vérité de référence ou une grille
- Isoler l’environnement et retirer les secrets inutiles
- Placer des validations aux changements de risque
- Mesurer résultat, interventions, coût et erreurs
- Reproduire puis décider : arrêter, corriger ou étendre
Les cinq métriques qui valent mieux que le nombre de jetons
Première métrique : le taux de résultats acceptés sans correction majeure. Deuxième : le temps humain total, du cadrage à la validation. Troisième : le coût complet par résultat accepté. Quatrième : la reproductibilité avec les mêmes sources et versions. Cinquième : les incidents évités ou déclenchés, notamment accès non autorisé, donnée exposée, test contourné ou conclusion sans preuve.
Complétez par le taux de refus approprié. Un agent fiable doit savoir s’arrêter lorsque les sources ne suffisent pas ou qu’une permission manque. Suivez aussi la concentration des échecs : un taux moyen correct peut cacher une erreur systématique sur les chiffres, la langue française ou les longues tâches. Conservez quelques cas inchangés pour comparer les versions au fil du temps, sans entraîner la procédure uniquement sur le test.
Ce que l’annonce ne permet pas de conclure
Elle ne démontre pas que l’IA remplace un chercheur, que la productivité a été multipliée par 3,1 ou que toutes les tâches de plusieurs jours sont désormais automatisables. Les mesures couvrent la majeure partie, mais pas la totalité, des usages internes ; elles restent préliminaires. Le calcul croissant brouille l’attribution et les graphiques reposent sur les activités d’une seule organisation qui développe elle-même les outils étudiés.
Elle ne fournit pas non plus un produit, un prix ni une date de disponibilité en France ou en Europe. Il serait trompeur d’acheter un abonnement en supposant accéder à ce système interne. Ce que le public obtient aujourd’hui est un ensemble de définitions, de métriques et de limites utile pour mieux questionner les annonces futures. Il faut attendre des reproductions, des comparaisons externes et des résultats scientifiques concrets avant de généraliser.
Verdict : un signal majeur, encore loin d’un laboratoire autonome
Le document d’OpenAI mérite l’attention parce qu’il expose plus qu’une démonstration : niveaux d’usage, types de tâches, interventions et effets de restrictions de sécurité. Il montre que des agents participent déjà massivement au code, aux expériences et au dépannage d’un laboratoire de pointe. Cette intégration peut accélérer certaines boucles de recherche et déplacer rapidement la frontière de ce qui devient économiquement faisable.
Mais le même document contient les raisons de rester précis. La planification de haut niveau est rare, les interventions humaines restent fréquentes, l’activité n’est pas le progrès et les garde-fous peuvent déplacer plutôt qu’annuler le calcul. La question utile n’est donc pas « l’IA fait-elle désormais de la recherche seule ? ». C’est : quelles tâches réussit-elle, avec quelles preuves, quels coûts, quelles interventions et quel pouvoir d’arrêt humain ?
Ce qu’il faut encore savoir
OpenAI a-t-il lancé un nouveau produit pour les chercheurs ?
Non. L’annonce décrit des capacités et usages internes au sein de l’organisation de recherche. Aucun produit, prix ou calendrier commercial en France ou en Europe n’est annoncé.
Les 3,1 journées-agent signifient-elles trois fois plus de productivité ?
Non. Il s’agit de temps d’exécution agrégé normalisé. Il faut encore mesurer les résultats validés, le coût, les interventions humaines et les erreurs pour estimer un gain de productivité.
Un agent peut-il mener seul une tâche de plusieurs jours ?
OpenAI dit réussir certaines tâches bien définies de cette longueur sous direction humaine. Plus de la moitié des tâches réussies de quatre à huit heures ont toutefois nécessité au moins une intervention.
Quelle première tâche choisir pour tester un agent ?
Une tâche limitée, réversible, sans donnée sensible, avec un résultat connu ou une grille claire : comparer des documents publics, exécuter des tests dans un dépôt fictif ou préparer une synthèse sourcée.
Quand faut-il arrêter le test ?
Arrêtez si l’agent dépasse le périmètre, demande des accès disproportionnés, invente des preuves, contourne un contrôle, consomme le budget sans signal de progrès ou produit un résultat impossible à reproduire.
Sources et vérification
Les liens ci-dessous permettent de contrôler les informations réglementaires et les données citées. Consultation : 6 septembre 2026.