Évaluer un modèle de raisonnement IA avant de le mettre en production
Une méthode en sept jours pour tester un modèle de raisonnement sur vos propres tâches, mesurer qualité, coût et latence, puis décider sans se fier à un classement.
Rédaction Cresora IAVeille mondiale · Méthode éditoriale vérifiableObjectif : passer d’une démonstration séduisante à une décision documentée, réversible et fondée sur des cas réels anonymisés.Dossier : Comparer les modèles IA du monde entier →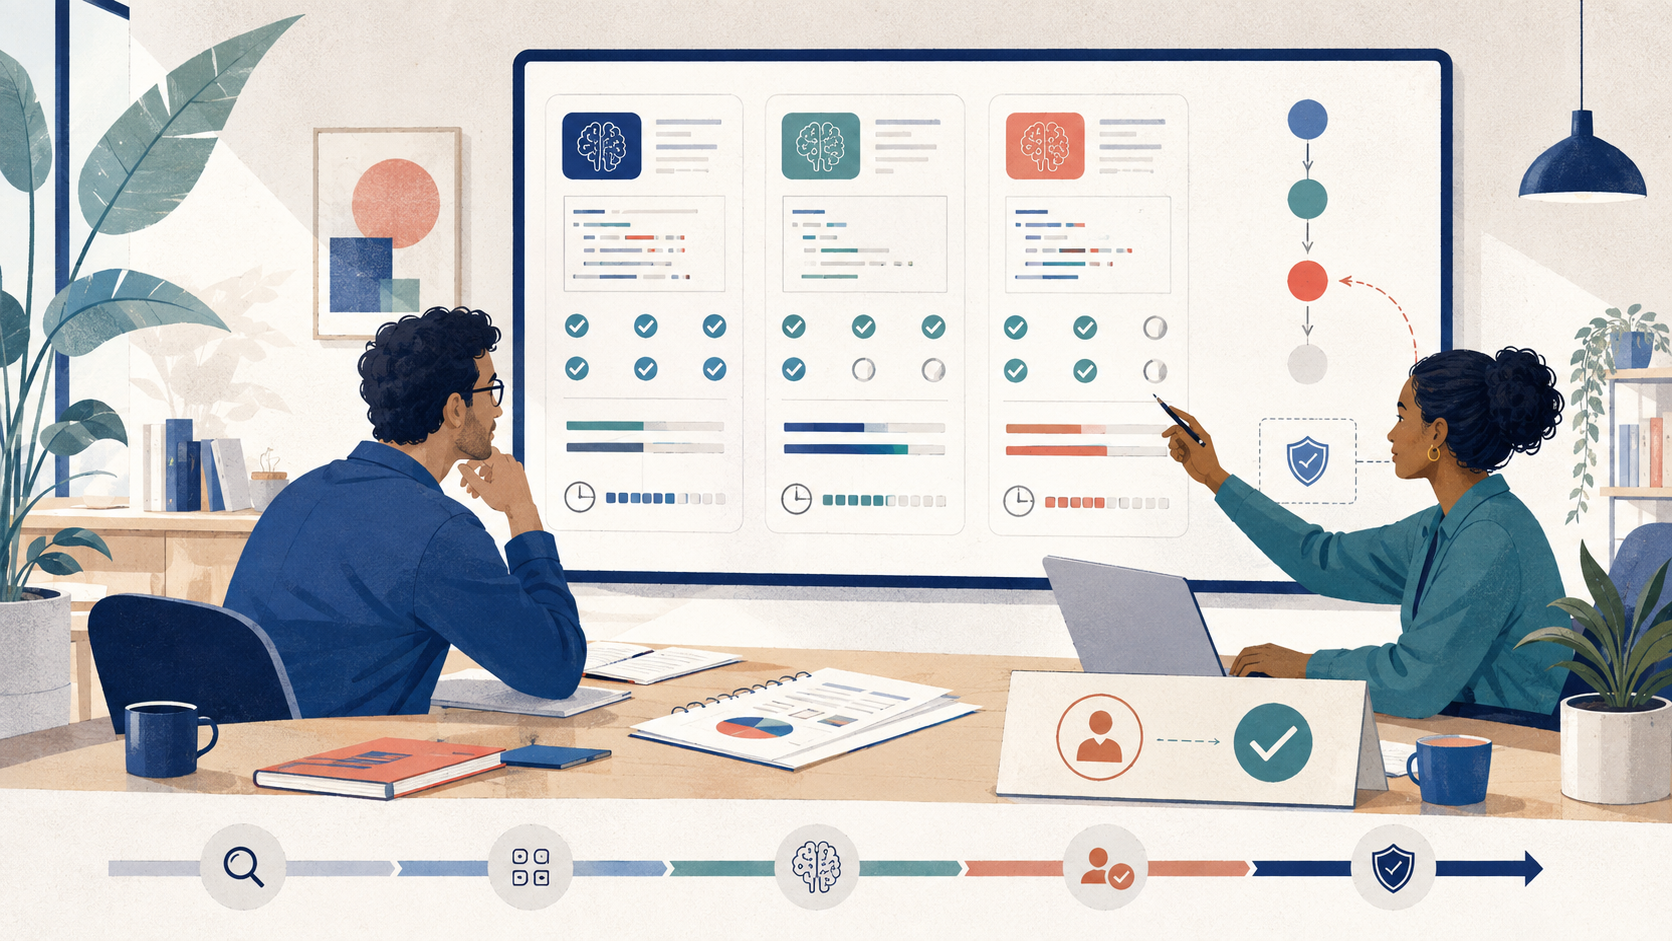
Pourquoi un bon score ne suffit pas
Un modèle de raisonnement peut obtenir un excellent résultat en mathématiques ou en code et rester maladroit sur un devis français, une procédure interne ou une réponse client. Les benchmarks décrivent une tâche, une version, un protocole et parfois un réglage précis. Ils ne mesurent pas automatiquement votre vocabulaire, vos documents, vos contraintes de délai ni le temps de correction humaine.
Microsoft présente MAI-Thinking-1 comme un modèle à mélange d’experts d’environ 35 milliards de paramètres actifs et un billion au total. Le fournisseur publie notamment des résultats sur AIME, SWE-Bench Pro et une comparaison humaine face à Sonnet 4.6. Ces éléments sont utiles pour présélectionner le modèle. Ils restent des mesures publiées par son créateur et ne prouvent ni sa supériorité générale, ni sa qualité en français, ni son coût réel dans votre flux de travail.
La bonne question n’est pas « quel modèle gagne ? », mais « lequel atteint notre seuil de qualité sur cette tâche, à ce coût et avec ce niveau de contrôle ? »
Commencer par une décision mesurable
Définissez ce que le test doit décider avant d’ouvrir un portail ou une API. Vous pouvez chercher à remplacer un modèle devenu trop cher, ajouter une solution de contrôle, réduire le temps de revue d’un document ou améliorer la réussite d’une extraction structurée. Une intention vague comme « tester la nouvelle IA » produit surtout des impressions.
Écrivez un seuil et une conséquence. Par exemple : le candidat doit respecter le schéma JSON dans 98 % des cas, ne perdre aucun fait obligatoire et réduire le coût médian d’au moins 15 % sans ajouter plus de trente secondes. Si aucun candidat ne franchit les seuils, la décision valable est de conserver l’existant. Le test n’a pas besoin d’avoir un vainqueur.
- Tâche visée et utilisateur concerné
- Résultat attendu
- Erreur inacceptable
- Seuil minimal de qualité
- Budget par dossier
- Délai maximal
- Décision si le test échoue
Construire un jeu de test représentatif
Réunissez trente à cent cas couvrant les situations fréquentes, difficiles et rares mais coûteuses. Pour une TPE, cela peut être des demandes clients fictives, des extraits de cahiers des charges publics, des tableaux synthétiques et des réponses attendues validées. Retirez les noms, coordonnées, secrets, contrats et données personnelles ; lorsque l’anonymisation altère le sens, créez un cas synthétique plutôt que de transférer le dossier réel.
Conservez les fautes, ambiguïtés et formats que vos utilisateurs rencontrent. Un jeu uniquement composé de consignes propres surestime la performance. Ajoutez des demandes où la bonne réponse consiste à signaler une information manquante, refuser de calculer un montant non justifié ou demander une validation. Séparez ensuite le jeu de réglage du jeu final pour éviter d’optimiser les prompts sur les réponses qui serviront à juger.
- 60 % de cas fréquents
- 20 % de cas difficiles
- 10 % de données incomplètes
- 10 % de cas à refuser ou escalader
- Au moins un tiers en français naturel
- Réponses attendues et critères validés avant le test
Comparer à conditions égales
Fixez la version exacte, les instructions, les outils autorisés, la température, la limite de sortie et le nombre de tentatives. Si un modèle dispose de recherche web et l’autre non, comparez soit les modèles sans outil, soit les solutions complètes en notant la différence. Ne mélangez pas une réponse obtenue après cinq relances avec le premier résultat d’un concurrent.
Exécutez les cas automatiquement lorsque c’est possible, mais gardez un échantillon relu à l’aveugle. Masquez le nom du modèle au relecteur et alternez l’ordre des réponses. Mesurez la première sortie, puis le résultat après une seule correction standardisée. Cette seconde mesure révèle la capacité du modèle à récupérer d’une erreur sans transformer le test en séance de prompt improvisée.
Noter la qualité avec une grille métier
Les évaluateurs génériques de cohérence ou de fluidité sont utiles, mais un texte élégant peut inventer un engagement. Créez une grille courte reliée à la conséquence métier : exactitude des faits, couverture des champs, respect du format, justification, incertitude, ton et absence d’action non autorisée. Donnez davantage de poids aux erreurs qui peuvent déclencher un paiement, une publication ou une mauvaise décision.
Microsoft Foundry permet d’évaluer un modèle ou un agent sur un jeu existant ou synthétique. Utilisez ces fonctions pour répéter les mesures, pas pour déléguer la définition de la réussite. Si un autre modèle sert de juge, contrôlez un échantillon humain et documentez sa version : un juge automatique peut préférer un style proche du sien ou manquer une règle métier.
- Exactitude factuelle : 0 à 5
- Respect des instructions : 0 à 5
- Format exploitable : 0 à 5
- Incertitude signalée : 0 à 5
- Temps de correction humaine : minutes
- Erreur critique : oui ou non
Mesurer coût, latence et variabilité
Le prix affiché par million de jetons n’est qu’une composante. Comptez les entrées longues, les sorties, les outils, les nouvelles tentatives, l’évaluation, le stockage, la supervision et le temps humain. Utilisez le coût médian par dossier et le 95e percentile : quelques requêtes très longues peuvent rendre un scénario imprévisible même si la moyenne semble basse.
Mesurez aussi le délai avant le premier jeton, le temps total et la dispersion. Un modèle de raisonnement peut réfléchir plus longtemps sur les cas difficiles. Ce délai est acceptable pour une analyse nocturne et gênant dans une interface client. Répétez plusieurs fois un sous-ensemble : si la décision change fortement pour une même entrée, ajoutez une règle de contrôle ou écartez le cas d’usage.
Traiter une préversion comme une préversion
MAI-Thinking-1 est annoncé en préversion publique dans Microsoft Foundry. Une préversion permet d’apprendre et de prototyper, mais ses capacités, quotas, régions, conditions ou identifiants peuvent évoluer. La documentation Microsoft rappelle que certaines fonctions en préversion ne disposent pas d’accord de niveau de service et ne sont pas recommandées pour les charges de production.
Utilisez donc un projet séparé, des données synthétiques, un budget plafonné et aucun engagement irréversible. Vérifiez la région disponible, les conditions de traitement, la conservation des journaux et les droits d’accès le jour du test. L’annonce ne publie pas de prix vérifié propre à MAI-Thinking-1 ni de calendrier de disponibilité générale : ne les inventez pas dans une estimation.
Une préversion peut gagner votre essai sans gagner le droit de recevoir vos données de production.
Organiser un pilote en sept jours
Le premier jour, verrouillez la décision et les seuils. Les jours deux et trois, préparez les cas, la vérité attendue et les erreurs critiques. Le quatrième jour, exécutez le modèle actuel et le candidat avec la même configuration. Le cinquième, réalisez la revue aveugle. Le sixième, calculez qualité, coût et latence. Le septième, décidez avec les personnes qui assument le risque et l’exploitation.
Conservez les entrées anonymisées, sorties, versions, paramètres et notes. Un tableau simple suffit. Le rapport final doit montrer les distributions et les échecs, pas seulement un score moyen. Ajoutez trois exemples où le candidat est meilleur et trois où il est moins bon. Cette transparence évite qu’une démonstration spectaculaire masque une régression silencieuse.
- J1 : décision et seuils
- J2–J3 : jeu de test et réponses attendues
- J4 : exécution comparative
- J5 : revue à l’aveugle
- J6 : coût, latence et erreurs
- J7 : décision et plan de retour arrière
Passer en production par étapes
Si les seuils sont franchis, commencez par du trafic interne ou des brouillons sans effet externe. Passez ensuite à une petite part des demandes, avec validation humaine obligatoire. Comparez en continu au modèle précédent et arrêtez le pilote si une erreur critique apparaît. La migration ne devient complète qu’après une période stable couvrant les principaux cas.
Préparez le retour arrière avant le premier utilisateur : ancien modèle encore disponible, prompts versionnés, schémas compatibles et indicateurs d’alerte. Microsoft décrit une migration en phases — inventorier, comparer, adapter, valider, déployer progressivement puis retirer. Cette discipline réduit la dépendance à une marque et facilite le prochain changement.
Cas pratique : qualifier une demande client
Une agence veut extraire besoin, budget mentionné, délai, pièces manquantes et prochaine question depuis des courriels. Elle crée cinquante demandes synthétiques en français, dont dix ambiguës et cinq qui contiennent une instruction malveillante dans une pièce jointe fictive. La règle interdit au modèle de proposer un prix ou d’envoyer une réponse.
Le candidat respecte mieux le format mais transforme deux hypothèses en faits. Son coût est inférieur et sa latence supérieure. L’équipe ajoute une vérification déterministe des champs, impose une citation de la phrase source et réserve le modèle aux brouillons internes. Elle garde l’ancien système pour le trafic externe jusqu’à quatre semaines sans erreur critique.
La fiche de décision finale
Résumez la version testée, la date, les régions, le jeu, les seuils, les résultats, les incidents, le coût complet et les limites. Indiquez ce qui relève du fournisseur, de votre mesure ou d’une hypothèse. Faites signer la décision par le propriétaire du cas d’usage, pas par le seul technicien qui a conduit l’essai.
Programmez une nouvelle évaluation après un changement de modèle, de prompt, d’outil ou de données. Une référence « latest » peut évoluer sans que vos critères changent. Le meilleur résultat est un processus capable de dire non, de détecter une régression et de revenir en arrière — pas un classement figé.
Ce qu’il faut encore savoir
Combien de cas faut-il pour commencer ?
Trente cas bien choisis donnent un premier signal. Pour une décision de production, augmentez le volume, couvrez les erreurs rares et calculez l’incertitude autour des résultats.
Peut-on utiliser un autre modèle comme juge ?
Oui pour accélérer, à condition de définir la grille, figer le juge et contrôler manuellement un échantillon. Il ne remplace pas la validation métier.
Un meilleur benchmark signifie-t-il un coût plus faible ?
Non. Le coût dépend des jetons, du temps de raisonnement, des outils, des relances, de l’hébergement et de la correction humaine.
Faut-il tester MAI-Thinking-1 maintenant ?
Seulement dans un pilote réversible si Foundry est déjà pertinent pour votre organisation. La préversion ne justifie ni migration urgente ni données sensibles.
Sources et vérification
Les liens ci-dessous permettent de contrôler les informations réglementaires et les données citées. Consultation : 4 septembre 2026.