K2 Horizon : six modèles ouverts, de l’appareil local au serveur
IFM publie six modèles K2 Horizon de 0,9 à 375 milliards de paramètres. Ce qui est réellement ouvert, les besoins matériels et une méthode d’évaluation sans croire les benchmarks maison.
Rédaction Cresora IAVeille mondiale · Méthode éditoriale vérifiableObjectif : comprendre la famille K2 Horizon et déterminer quelle taille mérite un essai local ou hébergé, sans migration précipitée.Dossier : Comparer les modèles IA du monde entier →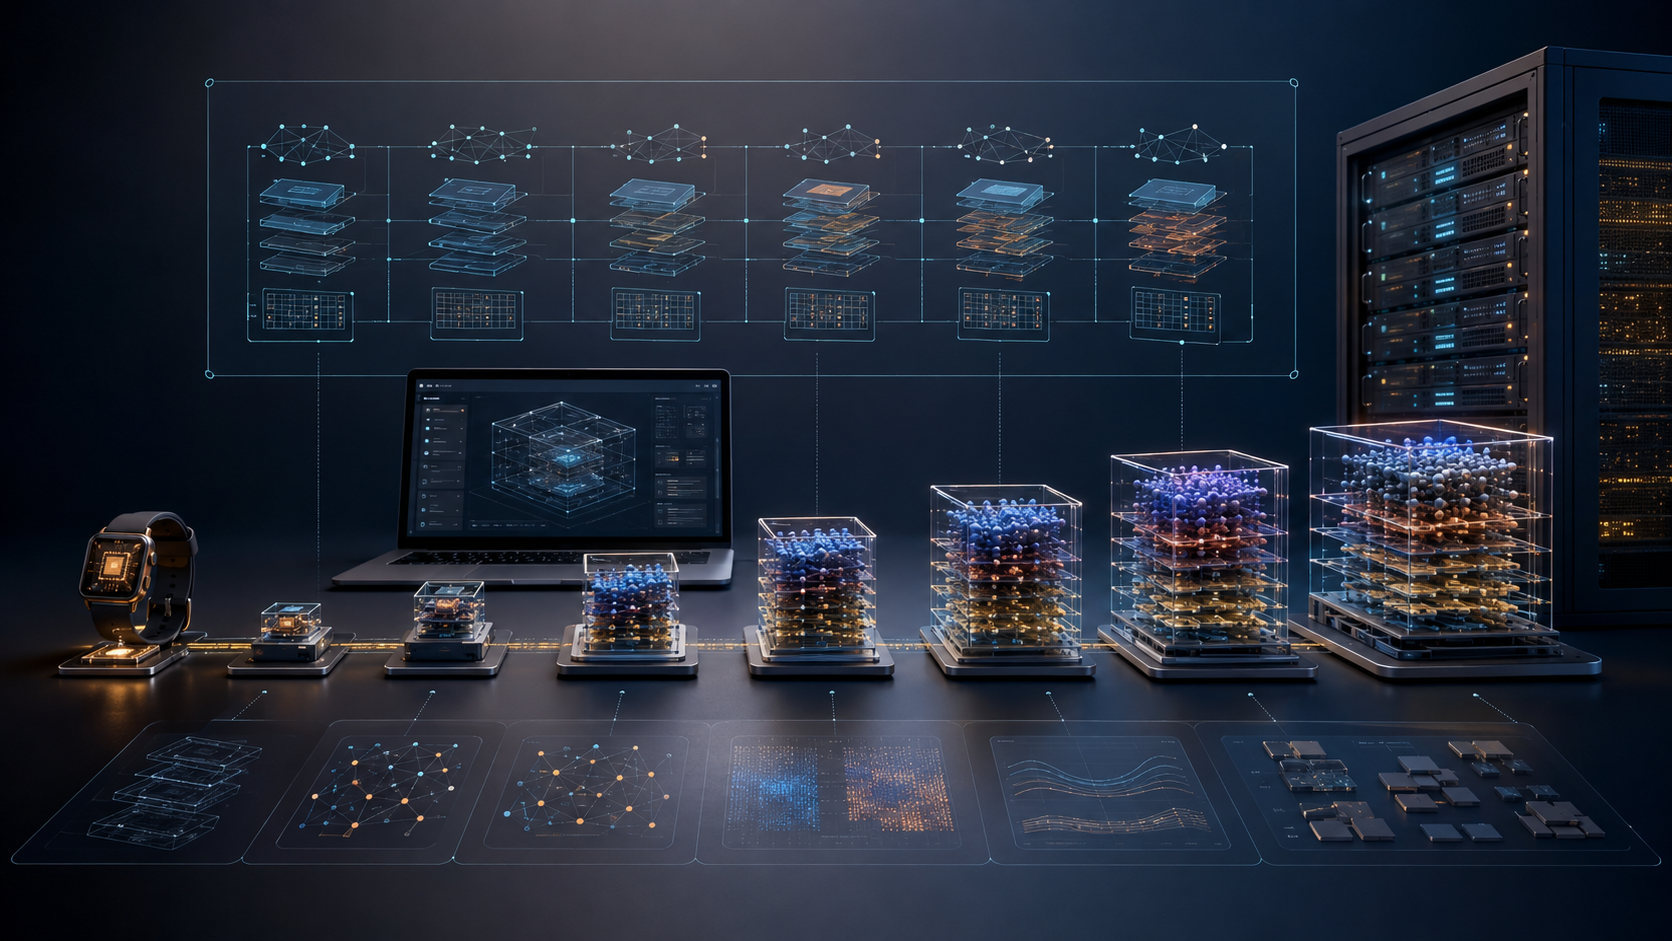
Une famille conçue pour plusieurs niveaux de matériel
L’Institute of Foundation Models, lié à MBZUAI, a publié le 3 septembre 2026 K2 Horizon. La famille comprend six tailles : 0,9B, 3,7B, 7B, 32B dense, 36B-A4B avec architecture MoVA, et 375B-A23B. L’idée annoncée est de conserver une base commune depuis les appareils très contraints jusqu’aux infrastructures serveur.
Cette amplitude est plus importante que la seule taille du modèle vedette. Elle peut permettre à une équipe de prototyper sur un petit modèle, puis de monter en capacité sans changer complètement de vocabulaire et d’outils. Elle ne garantit pas que les comportements, coûts ou performances restent identiques entre tailles. Chaque modèle doit être traité comme un produit distinct.
Fait : six modèles et leurs poids sont publiés. Analyse : la cohérence d’une famille peut réduire la friction, mais elle ne remplace pas les tests de qualité et de coût.
Dense, MoVA et paramètres actifs : lire les noms correctement
Un modèle dense mobilise généralement l’ensemble de ses paramètres à chaque étape de génération. Les versions 36B-A4B et 375B-A23B indiquent une architecture où seule une partie des paramètres est active pour un jeton. Le total décrit la capacité stockée ; la valeur après A donne un ordre de grandeur du calcul actif annoncé.
Cette distinction n’autorise pas à convertir directement les paramètres actifs en mémoire nécessaire. Les poids complets doivent souvent rester accessibles, auxquels s’ajoutent le cache de contexte, le moteur d’inférence et les marges. La quantification, la longueur réelle des requêtes et le nombre d’utilisateurs changent fortement le besoin. Ne choisissez jamais une machine sur le seul suffixe du modèle.
La promesse de 512K de contexte
Les cartes de la collection indiquent une fenêtre native de 512K. Une grande fenêtre peut aider à parcourir un dépôt, plusieurs rapports ou une longue conversation. Elle ne signifie pas que chaque information sera retrouvée avec la même fiabilité, ni que le coût mémoire restera raisonnable.
Testez la récupération à différentes positions, les contradictions entre documents et la résistance aux instructions malveillantes incluses dans les fichiers. Mesurez la latence avec 8K, 32K puis un contexte réellement long. Un système de recherche documentaire bien conçu peut être plus rapide et plus contrôlable que l’envoi systématique de centaines de milliers de jetons.
Ce qui est ouvert aujourd’hui et ce qui reste promis
IFM publie la famille sous Apache 2.0 et met en avant les poids, configurations, journaux, évaluations, recettes ou jeux de données, ainsi que des branches d’entraînement. Cette transparence dépasse une publication limitée au fichier final et facilite l’audit de certaines étapes.
Cependant, les cartes signalent encore que des checkpoints intermédiaires, du code d’entraînement complet ou certains artefacts finaux doivent arriver plus tard. L’expression « entièrement ouverte » doit donc être auditée dépôt par dépôt et à une date précise. Téléchargez la licence de chaque composant, identifiez les données tierces et consignez ce qui manque avant de promettre une reproductibilité complète.
- Vérifier la licence du modèle exact
- Lister poids, tokenizer et configuration
- Contrôler code, recettes et données publiés
- Noter les artefacts annoncés ultérieurement
- Dater l’audit et conserver les liens
Benchmarks : des signaux, pas un classement définitif
IFM compare les tailles sur AIME 2026, SWE-bench, BrowseComp, TerminalBench et d’autres tests. Les cartes documentent des paramètres et efforts, ce qui aide à interpréter les résultats. Mais les évaluations sont exécutées et sélectionnées par le fournisseur ; aucun audit indépendant complet n’est présenté dans les sources de lancement.
Un score en mathématiques ou en code ne mesure pas la qualité du français, le respect d’un ton, la sécurité d’un agent ni la valeur sur vos documents. TerminalBench reste difficile aux petites tailles selon les résultats publiés. Utilisez les tableaux pour retenir deux candidats, puis exécutez un jeu interne identique et anonymisé. Ne déclarez pas K2 supérieur sur la base du communiqué.
Quel modèle essayer selon le contexte
Les modèles 0,9B et 3,7B peuvent intéresser les appareils contraints, les fonctions courtes et les prototypes. Le 7B est un candidat naturel pour un poste local capable de faire tourner des modèles quantifiés. Le 32B et le 36B-A4B visent davantage une station puissante ou un serveur. Le 375B-A23B relève d’une infrastructure spécialisée ou d’une API partenaire.
Ce classement reste indicatif : IFM ne publie pas dans le communiqué une configuration française universelle pour chaque taille. Consultez la carte, le format des poids et la quantification disponible. Commencez par la plus petite taille qui réussit votre tâche. Monter en paramètres n’a de sens que si le gain mesuré compense mémoire, énergie, latence et exploitation.
Cas pratique : assistant documentaire pour une petite association
Une association veut interroger ses procédures publiques et préparer des réponses internes. Elle construit vingt questions en français, dont cinq impossibles à résoudre à partir des documents. Les données personnelles sont remplacées par des exemples fictifs. Elle teste d’abord le 7B local, puis un modèle supérieur hébergé si la qualité est insuffisante.
La grille mesure citation du passage, exactitude, refus d’inventer, qualité du français, temps de réponse et consommation. Le grand contexte n’est utilisé que pour comparer ; la version finale peut employer une recherche de passages. La décision ne porte pas sur le modèle le plus impressionnant, mais sur le plus petit système qui répond correctement avec une validation humaine acceptable.
Installer localement sans confondre démonstration et production
IFM annonce la compatibilité avec vLLM, SGLang et Ollama. Vérifiez la fiche du modèle, car la disponibilité d’un format ou d’une recette peut évoluer. Pour un essai, utilisez une machine isolée, téléchargez depuis le dépôt officiel et contrôlez l’empreinte si elle est fournie. Notez la version du moteur et du modèle.
Un service local n’est pas automatiquement privé. Les journaux, sauvegardes, interfaces réseau et droits des utilisateurs peuvent exposer les requêtes. Désactivez l’accès public par défaut, protégez l’API et limitez les répertoires accessibles. Pour un agent capable d’exécuter des outils, ajoutez un bac à sable et une approbation avant toute écriture ou commande.
API partenaires : la licence gratuite n’annule pas la facture
Les poids sont annoncés sous Apache 2.0, mais l’inférence reste payante en matériel, électricité, temps d’administration ou appels API. IFM cite Compass, Cerebras, AWS et Nebius comme voies d’accès. Les tarifs d’inférence de ces partenaires ne sont pas détaillés dans le lancement.
Comparez le coût par tâche validée. Ajoutez le nombre de jetons, les relances, la longueur de contexte, la revue humaine et les échecs. Vérifiez aussi la région de traitement, la conservation, le contrat et la disponibilité européenne de l’offre exacte. La présence d’un bureau IFM à Paris ne garantit pas que chaque API traite les données en France ou dans l’Union européenne.
Licence Apache 2.0 : large, mais pas magique
Apache 2.0 permet généralement l’usage, la modification et la redistribution sous ses conditions, avec des dispositions sur les notices et brevets. Cela ne règle pas automatiquement les droits sur les données fournies au modèle, les contenus générés, les marques, ni les obligations liées à votre secteur.
Conservez le fichier de licence et les notices avec la version déployée. Contrôlez les licences des jeux de données, adaptateurs et quantifications ajoutés par des tiers. Pour un usage commercial sensible, faites valider votre chaîne complète plutôt que de conclure à partir de la seule licence des poids. Ce guide n’est pas un avis juridique.
Le protocole d’évaluation en dix tâches
Préparez dix tâches représentatives : trois rédactions françaises, deux extractions avec citation, deux questions ambiguës, une tâche de code, une requête longue et un refus attendu. Écrivez les critères avant le test. Utilisez les mêmes paramètres, documents et format de sortie pour chaque taille.
Mesurez exactitude, français, citations, incertitude, latence, mémoire maximale et temps de correction. Exécutez plusieurs fois les tâches critiques. Ajoutez un contrôle des biais et des contenus risqués adapté à votre public. Conservez les résultats avec la date : un modèle, une quantification ou un moteur mis à jour peut changer la conclusion.
- Anonymiser les dix tâches
- Fixer les critères de réussite
- Tester la plus petite taille plausible
- Mesurer qualité, latence et mémoire
- Comparer au modèle actuel
- Tester les refus et instructions piégées
- Décider avec une date de révision
Une décision réversible, taille par taille
K2 Horizon mérite l’attention parce que la famille relie plusieurs échelles et expose davantage d’artefacts que de nombreux lancements open-weight. La prudence reste nécessaire : exhaustivité différée, benchmarks maison, coût de reproduction et qualité française encore à démontrer.
Traitez l’essai comme une option, pas une migration. Gardez vos prompts, tests et documents dans des formats indépendants. Placez l’adresse, le modèle et l’authentification derrière une configuration réversible. Si une taille réussit un usage étroit, déployez-la d’abord sur ce périmètre. L’ouverture utile se mesure à la capacité de comprendre, modifier et quitter le système sans perdre son travail.
Ce qu’il faut encore savoir
K2 Horizon est-il vraiment open source ?
IFM annonce les modèles sous Apache 2.0 et publie poids et plusieurs artefacts. Certains éléments restent toutefois annoncés pour plus tard ; il faut auditer chaque dépôt.
Quel modèle peut fonctionner sur un ordinateur personnel ?
Les tailles 0,9B, 3,7B et parfois 7B quantifiées sont les candidates les plus réalistes, selon la mémoire, le moteur et la longueur de contexte.
La fenêtre de 512K garantit-elle de comprendre un long document ?
Non. Elle indique une capacité de contexte annoncée, pas une récupération parfaite. Il faut tester précision, position des informations, coût et latence.
Peut-on utiliser K2 Horizon commercialement ?
Apache 2.0 est une licence permissive, mais vous devez vérifier les notices, composants tiers, données, obligations sectorielles et conditions de l’infrastructure utilisée.
Sources et vérification
Les liens ci-dessous permettent de contrôler les informations réglementaires et les données citées. Consultation : 3 septembre 2026.