Better Harness de Qoder passe à l’open source : évaluer un agent de code sur ses preuves
Publié sous licence MIT le 15 octobre 2026, Better Harness veut analyser le travail réel d’un agent de code. Voici ce que l’outil fait, ce qu’il ne prouve pas et comment le tester prudemment sur un petit projet.
Rédaction Cresora IAVeille mondiale · Méthode éditoriale vérifiableObjectif : comprendre si Better Harness peut aider une petite équipe à repérer une faiblesse vérifiable dans son usage des agents de code, sans confondre score, configuration présente et qualité réellement démontrée.Dossier : Comparer les modèles IA du monde entier →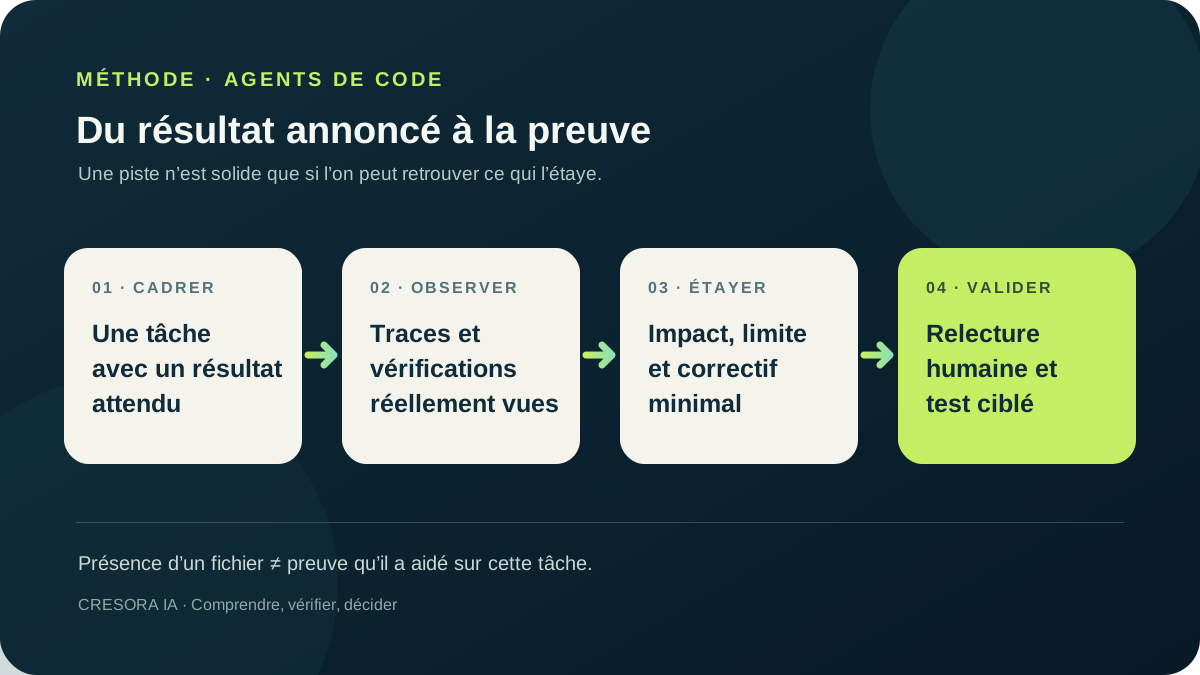
La réponse courte : un outil d’audit de workflow, pas un nouveau modèle de code
Better Harness n’est pas présenté comme un modèle qui écrit du code. C’est un outil d’analyse du travail autour d’un agent de programmation : a-t-il compris la tâche, travaillé dans un chemin contrôlé, vérifié son changement et livré un résultat que l’on peut examiner ? Qoder, l’équipe d’Alibaba à l’origine du projet, l’a annoncé comme open source le 15 octobre 2026. Le dépôt public indique une licence MIT.
L’intérêt potentiel est concret : au lieu de compter les fichiers de configuration d’un dépôt, Better Harness cherche à relier une recommandation à des éléments observables et à une façon de vérifier une correction. Cela peut aider une équipe à transformer un « l’agent fait parfois n’importe quoi » en une question plus limitée, par exemple : « sur cette tâche, le test pertinent a-t-il été exécuté et son résultat vérifié ? » Cela reste un appui à l’analyse, pas un verdict automatique sur la qualité de votre équipe ou de votre code.
À retenir : le rapport est une piste structurée. Gardez la main sur la décision, la revue du code et l’interprétation des preuves.
Ce qui a été publié le 15 octobre 2026
Dans son annonce, Alibaba Cloud décrit Better Harness comme un kit open source d’analyse et d’amélioration des workflows d’agents de code, basé sur l’exécution de tâches réelles. Le communiqué initial cite Claude Code, Codex, Qoder et Cursor, tout en précisant que les intégrations n’ont pas encore la même couverture des sessions, des preuves ou des formats de sortie. Le dépôt et son README évoluent : avant une installation, consultez leurs instructions et limites à jour plutôt que de recopier une commande trouvée dans un article.
Le fournisseur explique que l’outil examine plusieurs familles d’éléments : les sessions et appels d’outils lorsqu’ils sont accessibles, la capacité du projet à être démarré et vérifié, ainsi que les règles, compétences, hooks ou autres personnalisations d’agents. Une conclusion est censée préciser ses preuves, son impact pour l’utilisateur, le périmètre minimal de correction et le moyen de vérifier cette correction. Une preuve absente doit rester absente : elle ne devrait pas être remplacée par une supposition.
Le titre de l’annonce mentionne « 100 000 utilisateurs », mais cela ne signifie pas que 100 000 personnes ont installé le dépôt open source, ni que ce chiffre constitue une évaluation indépendante. Dans le corps de l’annonce, l’entreprise décrit également un premier exercice interne sur 30 projets GitHub et 120 rapports produits par quatre types de modèles, ensuite calibrés par des humains. Ces chiffres rapportent la méthode revendiquée par le fournisseur; les sources publiques consultées ne donnent pas un jeu de résultats indépendant permettant de la reproduire et de comparer objectivement les outils.
Pourquoi regarder une tâche plutôt qu’une liste de fichiers
Un dépôt peut contenir un fichier AGENTS.md, une suite de tests, une intégration continue et plusieurs règles d’agent sans que celles-ci aient aidé sur la tâche examinée. À l’inverse, une tâche peut être livrée correctement même si une catégorie de traces n’est pas disponible. Confondre ces situations produit deux erreurs : donner un bon score parce que les fichiers existent, ou accuser l’agent d’avoir échoué parce qu’on ne peut pas observer son activité.
L’approche décrite par Better Harness sépare donc, au moins dans sa conception, la capacité configurée du projet et le comportement effectivement observé pendant une tâche. Les dimensions annoncées couvrent la compréhension de la demande, l’exécution contrôlée, la vérification du changement, la fiabilité de la livraison et la conservation des apprentissages. Elles sont intéressantes comme grille de discussion; elles ne remplacent pas les critères propres à votre produit, votre langage, votre équipe et vos risques.
La différence avec une checklist classique tient à la chaîne de justification. « Le projet possède des tests » est un constat sur le dépôt. « Le test pertinent a été exécuté après cette modification et son résultat montre que le comportement attendu fonctionne » est une affirmation plus précise. Même celle-ci doit être contrôlée : un test vert peut être incomplet, mal ciblé ou incapable de détecter une régression hors de son périmètre.
À qui cela peut servir — et à qui l’outil n’apportera pas grand-chose
Better Harness mérite un essai si vous utilisez déjà un agent de code, répétez des tâches proches et avez besoin de comprendre où la boucle de travail se fragilise : objectif ambigu, commande de test oubliée, résultat non relu, chemin de livraison incertain ou apprentissage jamais réutilisé. Un responsable technique peut s’en servir pour ouvrir une discussion fondée sur un cas concret plutôt que sur une impression générale. Une personne indépendante peut aussi examiner une seule tâche pour améliorer sa propre checklist de remise.
Il est moins pertinent si vous n’utilisez pas encore d’agent de programmation, si votre projet n’a ni tâche répétable ni critère de résultat, ou si vous cherchez une garantie réglementaire, un audit de sécurité exhaustif ou un comparatif de modèles. L’outil ne décide pas si une fonctionnalité est souhaitable, si un correctif est sûr pour vos clients ou si une entreprise devrait confier son code à un fournisseur. Ces responsabilités restent humaines et dépendent du contexte.
Un essai prudent en six étapes pour une petite équipe
Choisissez une tâche représentative mais à faible risque, dans un dépôt dont vous avez le droit d’analyser les données. Écrivez avant le test ce qui constituerait une réussite : comportement attendu, tests à lancer, limites à ne pas franchir et personne qui validera le changement. Sans ce point de départ, il devient facile d’interpréter le rapport en fonction du résultat que l’on espérait déjà voir.
Consultez le README, la licence, les instructions propres à votre agent et les éléments qu’il collecte. Les supports et sorties ne sont pas identiques selon les hôtes. Ne supposez pas qu’une commande prévue pour Qoder fonctionne de la même manière dans Codex, Claude Code ou Cursor. Si le rapport utilise une trace que votre configuration ne fournit pas, notez cette limite; ne la traitez ni comme un échec ni comme une preuve positive.
Faites ensuite vérifier chaque constat important par une personne qui peut retrouver la source dans le dépôt ou la session. Pour chaque proposition, demandez : quelle observation l’étaye ? Quel impact utilisateur concret est plausible ? Quelle est la plus petite correction à tester ? Quel contrôle montrera qu’elle fonctionne ? Écartez ou reformulez tout constat qui ne répond pas à ces questions. Corrigez une seule faiblesse à la fois, puis répétez une tâche comparable pour vérifier si le workflow a réellement changé.
Commencez par un dépôt de démonstration ou un petit projet non confidentiel si vous ne connaissez pas encore le périmètre de collecte.
- Définir une tâche non sensible, un résultat attendu et un périmètre de dépôt autorisé.
- Vérifier le README, la licence MIT et les modalités de l’hôte que vous utilisez.
- Avant de lancer l’analyse, repérer quelles informations de projet ou de session peuvent être lues et où les rapports seront écrits.
- Relier chaque constat conservé à une trace, un impact, un correctif minimal et un contrôle d’acceptation.
- Faire relire le rapport et le changement par une personne; ne pas appliquer une recommandation uniquement parce qu’elle est accompagnée d’un score.
- Comparer une tâche semblable après correction, sans prétendre qu’un seul cas prouve une amélioration durable.
Cas pratique fictif : l’agent annonce la fin sans vérifier le bon scénario
Exemple fictif : une petite association demande à son agent d’ajouter un bouton d’export CSV à une page de suivi des adhésions. Le code compile, mais la personne qui vérifie ne sait pas si le fichier contient toutes les colonnes, si les accents sont conservés ou si les données personnelles sont exportées au-delà du besoin. Le problème n’est pas seulement « l’agent a-t-il écrit du code ? »; c’est aussi « la demande, les limites et la preuve de fin étaient-elles assez précises ? »
Une analyse de workflow peut aider à repérer si le cahier des charges initial nommait les colonnes, si un jeu de test sans données réelles a été utilisé, si le test d’export a été exécuté et si l’agent a déclaré explicitement ce qui restait non vérifié. L’équipe pourrait alors ajouter un critère de recette et un test sur des données factices, puis contrôler le fichier obtenu. Elle doit toujours elle-même inspecter le code et confirmer que l’export respecte son besoin.
Ce scénario ne constitue pas un résultat de Better Harness ni une démonstration de ses performances. Il montre comment transformer une inquiétude vague en une tâche bornée dont les critères, les traces et la validation peuvent être discutés.
Prix, licence et confidentialité : les limites à vérifier avant installation
Le code publié annonce une licence MIT, ce qui autorise l’usage et la modification du logiciel dans les conditions de cette licence. Cela ne rend pas automatiquement gratuits les modèles, abonnements d’agents, environnements de calcul ou services tiers utilisés autour de lui. Le coût opérationnel dépendra de vos outils, de vos comptes et du temps consacré à la revue; l’annonce ne fournit pas un prix universel pour un déploiement d’équipe.
La présence d’un dépôt public ne signifie pas que votre code privé doit être publié. Avant d’analyser un projet de travail, vérifiez le contrat de votre agent, les règles de l’employeur ou du client, le mode d’exécution, les permissions, les journaux et l’emplacement des rapports. Commencez par un projet non confidentiel et n’ajoutez ni clés, ni secrets, ni données de clients dans les consignes ou exemples. En cas de doute, demandez l’avis de la personne responsable de la sécurité ou des données de votre organisation.
Un outil d’analyse ne remplace pas les revues de sécurité, les tests métier, les contrôles d’accès, la sauvegarde ou le processus de déploiement. Il peut aussi manquer des éléments lorsque l’agent ou la plateforme ne rend pas certaines traces accessibles. La qualité du rapport dépend donc de la disponibilité des preuves, de leur interprétation et de la compétence de la personne qui valide les conclusions.
Ce que l’annonce confirme — et ce qu’elle ne démontre pas
Faits vérifiables dans les sources primaires consultées : le billet d’Alibaba Cloud est daté du 15 octobre 2026 et annonce la publication de Better Harness; le dépôt GitHub est public et son README indique une licence MIT; la documentation du fournisseur présente l’analyse de tâches d’agents de programmation et indique des différences de couverture selon les hôtes. Le communiqué expose aussi un premier exercice interne sur 30 projets et 120 rapports, avec une étape de calibration humaine.
Ce qui n’est pas établi par ces éléments : une amélioration mesurée de la qualité ou de la productivité par rapport à d’autres outils, un taux d’erreur, une couverture exhaustive de tous les agents, une disponibilité identique sur chaque plateforme, ou la pertinence d’un score pour une équipe particulière. Les chiffres d’évaluation décrits par Qoder ne constituent pas une comparaison indépendante et ne suffisent pas à reproduire les résultats. Une équipe doit donc tester son propre cas et publier ses limites, plutôt que reprendre une affirmation marketing comme un résultat général.
Ce qu’il faut encore savoir
Better Harness est-il un modèle d’intelligence artificielle ?
Non. Il est présenté comme un outil d’analyse des workflows autour d’agents de programmation. Il examine des éléments liés à une tâche et organise des constats; il ne remplace pas le modèle qui écrit le code.
Est-il vraiment open source et gratuit ?
Le dépôt public indique une licence MIT. Cela concerne le code publié, pas nécessairement les agents, modèles, services ou ressources de calcul qui peuvent être utilisés autour. Lisez la licence et les conditions des autres outils.
Le titre « 100 000 utilisateurs » prouve-t-il que le dépôt est déjà largement adopté ?
Non. Le titre de l’annonce reprend une affirmation de Qoder sur l’outil utilisé dans son produit. Il ne démontre pas combien de personnes ont installé le dépôt open source et ne constitue pas une mesure indépendante.
L’outil peut-il garantir que le code généré est sécurisé ?
Non. L’analyse d’un workflow ne constitue pas une certification de sécurité. Maintenez revue humaine, tests adaptés, analyse de sécurité et règles de déploiement propres à votre projet.
Est-il compatible avec tous les agents de code de la même manière ?
Non. L’annonce initiale et le README indiquent des différences de couverture et de format selon les hôtes. Consultez la matrice et les instructions actuelles du dépôt pour votre agent précis.
Peut-on l’essayer sur le dépôt de son entreprise ?
Uniquement si vous êtes autorisé à le faire et après avoir vérifié ce qui sera lu ou enregistré. Commencez par un projet non sensible et suivez les règles de sécurité, de confidentialité et de propriété intellectuelle de votre organisation.
Un score élevé prouve-t-il que l’agent travaille bien ?
Non. Un score sert au mieux de repère dans une méthode donnée. Examinez les preuves, le périmètre et les limites, puis vérifiez le résultat sur une tâche comparable.
Sources et vérification
Les liens ci-dessous permettent de contrôler les informations réglementaires et les données citées. Consultation : 17 octobre 2026.